심리학 영역을 다루는 상위 세 저널에서 수집한 p값(p-value) 3,627개의 분포 모양을 그려보니 0.045와 0.050 사이에 설명하기 어려운 쏠림이 관찰되었습니다. 그 쏠림의 흔적이 p-hacking입니다. 유혹은 도덕이 아니라 절차로 예방해야 합니다. 사전에 설정한 통계분석 계획과 정확한 보고가 그 절차입니다.

이 글의 순서 6개 항목
1925년, 통계학자인 로널드 피셔는 교과서를 쓰면서 하나의 기준을 정했습니다. 연구 결과를 우연으로 보기 어렵다고 판정하는 기준으로 20분의 1, 곧 0.05가 편리하다고 적었습니다. 이 숫자에는 특별한 수학적인 근거가 전혀 없었습니다. 그런데 편의로 정한 이 기준은 이후 한 세기 동안 논문 게재의 당락을 쥐락펴락하는 절대적인 합격선이 되었습니다. p값(p-value)이 유의확률 0.05보다 작은 결과는 학술지에 실렸고, 그 값보다 큰 결과는 논문이 되지 못한 채 버려졌습니다. 합격선이 논문의 운명을 가르게 되자, 0.05를 살짝 넘긴 p값을 ‘손질’해서 그 아래까지 끌어내리려는 시도가 뒤따랐습니다. 2012년, 두 심리학자가 학술지에 실린 수천 개의 p값을 분포로 그리고 그 시도의 흔적을 찾아냈습니다. 이 글은 p값이 0.05 바로 아래에 몰리는 현상, 그리고 그 뒤에 숨겨져 있는 p-hacking의 이야기를 다룹니다.
유의확률 0.05 아래에서는 왜 그리 많은 p값들이 몰려 있는가?
이야기는 두 심리학자의 호기심에서 시작됩니다. 미국 웨이크포리스트대학교의 Masicampo와 캐나다 퀘벡대학교의 Lalande는 학술지에서 나타나는 p값들이 어떤 모양으로 분포하는지가 궁금하였습니다. 두 사람은 심리학의 상위 저널 세 곳을 선택했습니다. Journal of Personality and Social Psychology, Journal of Experimental Psychology: General, 그리고 Psychological Science였습니다. 각 저널에서 12개 호(issue)를 검색하고 0.01과 0.10 사이의 p값 3,627개를 수집하였습니다.
이론상으로 p값의 분포는 곡선의 모양을 보여야 합니다. 실제로 0.10에서 0.01 쪽으로 갈수록 p값의 개수가 서서히 늘어나는 곡선이 나타났습니다. 그런데 문제는 곡선 위의 한 지점이었습니다. 0.045와 0.050 사이 구간에서만 p값의 개수가 주변값의 추세로 예측한 수를 훌쩍 뛰어 넘었습니다. 매끄러운 언덕 위에 무언가가 솟아 있었던 셈입니다. 이 모양은 세 저널 모두에서 관찰되었습니다. 그리고 구간의 폭을 수정해서 다시 계산한 결과도 동일하였습니다. 연구의 목적을 모르는 조교가 한 저널로부터 p값을 수집하고 다시 분석한 후에도 동일한 패턴이 관찰되었습니다.
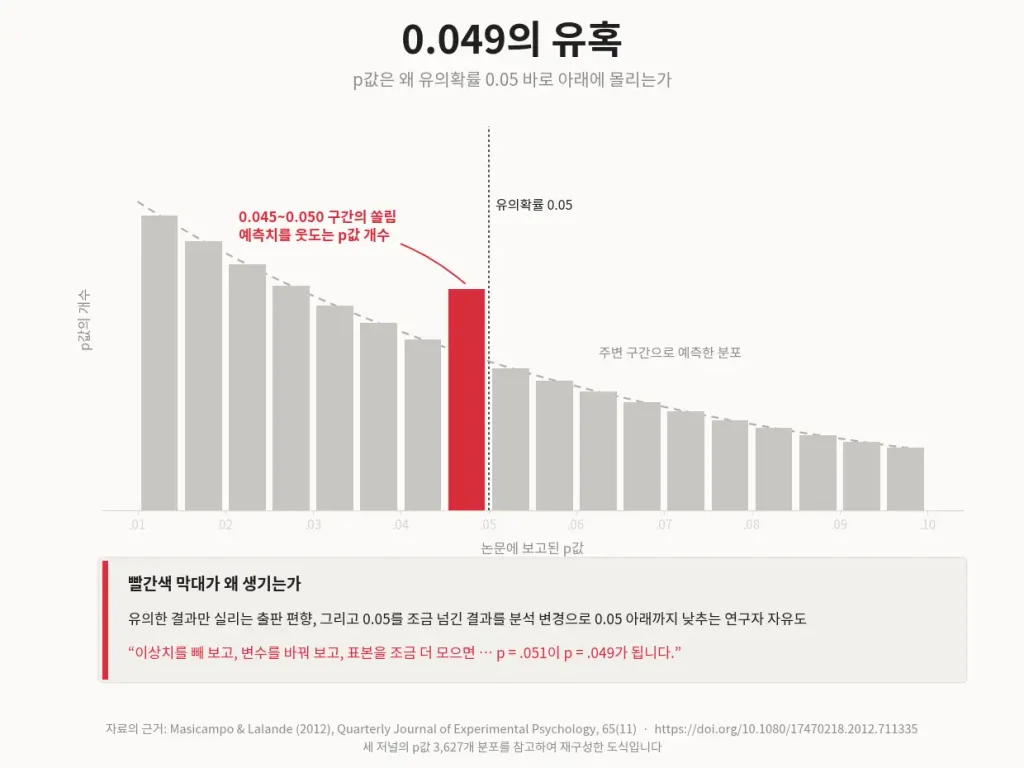
위의 그림에서 붉은 색상은 무엇을 의미할까요? 저자들은 두 가지 이유를 지목하였습니다. 하나는 통계적으로 유의한 결과가 담긴 논문만을 게재하는 출판의 편향(publication bias)입니다. 그리고 다른 하나는 0.05를 살짝 넘긴 분석 결과를 수정해서 0.05까지 낮추려 하는 연구자의 ‘개입’입니다. 이 게시물은 그 개입에 ‘0.049의 유혹’이라는 이름을 붙이려고 합니다.
- Masicampo, E. J., & Lalande, D. R. (2012). A peculiar prevalence of p values just below .05. Quarterly Journal of Experimental Psychology, 65(11), 2271–2279. https://doi.org/10.1080/17470218.2012.711335
무엇이 원래의 p값을 0.049로 만드는가?
이에 대한 해답은 연구자의 자유도(researcher degrees of freedom)에 있습니다. 이 용어를 만든 Simmons et al.(2011)이 한 가지의 실험을 수행하였습니다. 연구진은 통계분석 과정에서 선택할 수 있는 네 가지 종류의 연구자 ‘재량’을 시뮬레이션에 입력하였습니다. 이들 ‘재량’은 (1) 두 종속변수 중에서 유리한 쪽을 고르는 선택, (2) 결과의 패턴을 관찰하면서 표본을 10명씩 더 수집하는 선택, (3) 공변량의 입력과 제거를 반복적으로 선택, 그리고 (4) 실험 조건의 일부만을 보고하는 선택입니다. 이들 재량 하나하나는 무척 사소해 보입니다. 그런데 시뮬레이션을 수행해 보니 제1종 오류(Type I error)의 확률, 즉 효과가 없음에도 유의하다고 잘못 판정할 확률이 5%가 아니라 60.7%까지 증가하였습니다. Simmons et al.(2011)의 원문에서는 이 확률을 거짓 양성률(false-positive rate)이라고도 일컫습니다. 효과가 전혀 나타나지 않았음에도 불구하고 세 번 중에서 두 번 가까이 유의한 p값이 나온다는 뜻입니다.
Simmons et al.(2011)은 또 다른 실험을 통해 그들의 발견을 증명하였습니다. 연구진의 실험에 참가한 피실험자들에게 비틀즈의 노래 중의 하나인 ‘When I’m Sixty-Four’를 들려주고 나이를 물었습니다. ‘재량’을 동원해서 분석을 수행해 보니 노래를 청취한 집단의 생년이 실제로 젊어졌다는 것이었고, p값은 0.05 이하인 것으로 나타났습니다. 노래를 들었다고 자신의 나이를 되돌릴 수는 없으니 이 결론은 명백한 거짓입니다. 그럼에도 불구하고 통계 분석의 결과는 유의한 것으로 나타났습니다. 악의가 없어도 ‘재량’을 통해 이런 일이 벌어지게 되는 것입니다.
그렇다면 실제로 우리 주변의 많은 연구자들은 이 재량을 얼마나 사용하고 있을까요?. John et al.(2012)는 2,155명의 심리학자에게 그들의 이름을 묻지 않고 설문조사를 수행하였습니다. 그리고 조사 결과에 따르면, 통계분석을 수행한 후에 그 결과가 유의한지의 여부를 확인하고 표본을 더 수집한 적이 있다는 응답이 전체의 55.9%를 차지하는 것으로 나타났습니다. p=0.054(>0.05)을 0.05로 수정해서 보고한 적이 있다는 응답도 22%에 달했습니다. 이러한 행위에 대해 John et al.(2012)의 원문에서는 그와 같은 행위를 ‘의심스러운 연구 관행(questionable research practices)’이라고 지칭하였습니다. p값의 분포에서 관찰된 이상한 현상이 ‘관행’을 통해 비롯될 수 있다는 점을 응답자들이 자백한 것입니다.
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- John, L. K., Loewenstein, G., & Prelec, D. (2012). Measuring the prevalence of questionable research practices with incentives for truth telling. Psychological Science, 23(5), 524–532. https://doi.org/10.1177/0956797611430953
논문 심사위원은 p값의 분포에서 무엇을 읽는가?
만약 관찰된 효과가 유의하다면, 이에 대한 p값은 0.05 근처에서가 아니라 훨씬 작은 값으로 수렴하게 됩니다. Simonsohn et al.(2014)는 이 특징을 이용하여 진단을 위한 도구로 사용하였습니다. 유의한 p값들의 분포 곡선, 곧 p-curve를 그리고 만약 곡선이 작은 값 쪽으로 기울면 연구자의 개입이 없다고 판단하는 것입니다. 그러나 반대로 0.05 바로 아래에만 몰린 p곡선은 p-hacking의 흔적으로 읽을 수 있다고 주장하였습니다. 이 방법은 이미 논문의 심사과정에서 사용되고 있는 것으로 알려져 있습니다. 만약 어떤 논문에서 0.04대의 p값이 계속 등장한다면 심사위원은 저자를 매우 의심할 수 밖에 없습니다.
앞에서 소개한 연구의 결과는 세 곳의 심리학 저널만을 대상으로 조사한 것이었습니다. 그런데 이 조사 방식은 이후 다른 학문의 영역으로도 확대되었습니다. Head et al.(2015)은 컴퓨터 프로그램을 사용하여 인터넷에 공개되어 있는 수만 편의 논문으로부터 p값을 수집하였습니다. 그리고 수집한 p값을 여러 연구 영역별로 분류하고 분포의 모양을 그렸습니다. 그런데 연구진의 결과에서는 심리학 영역 뿐만 아니라 다른 여러 학문분야에서도 공통된 분포의 모양이 관찰되었습니다. 즉, 0.05 바로 아래 구간에 유난히 많은 p값들이 집중되어 있었던 것입니다. 연구진은 p값을 0.05 아래로 내리려는 p-hacking이 특정한 연구분야에서 볼 수 있는 문제라기 보다는 과학계 전체에서 일어나는 연구자의 개입이라고 결론을 지었습니다.
하지만 Lakens(2015)는 Head et al.(2015)의 연구결과를 정면으로 반박하고 나섰습니다. Lakens(2015)의 반박 요지는 크게 두 가지입니다. 첫째는, p값이 특이한 분포의 모양을 가진다고 판정하기 위해서는 p값의 이상적인 분포를 먼저 알아야 하다는 것입니다. 이 기준의 변화에 따라 p값의 특이한 분포 모양이 관찰되기도 하고, 또는 관찰되지 않을 수 있다는 주장입니다. 둘째는, 다른 자료를 조사해 보니 p값이 0.05 아래에 몰려 있는 현상이 아예 나타나지도 않았다는 것입니다. 종합한다면, p-hacking이 과학계의 전반에 퍼져 있다는 주장은 아직 확정된 사실이 아니며, 지금도 학자들 사이에서 치열한 논쟁이 이어지고 있습니다. 하지만 이들의 논쟁과는 무관하게, p=0.049라는 숫자가 심사과정에서 의심을 받는 상황은 이미 현실이 되어 버렸습니다. 따라서 연구자에게 필요한 것은 논쟁의 승자를 기다리는 것이 아니라, 자신의 p=0.049가 정당한 분석을 통해서 얻어진 결과라고 입증할 수 있는 근거를 갖추는 것입니다.
- Simonsohn, U., Nelson, L. D., & Simmons, J. P. (2014). P-curve: A key to the file-drawer. Journal of Experimental Psychology: General, 143(2), 534–547. https://doi.org/10.1037/a0033242
- Head, M. L., Holman, L., Lanfear, R., Kahn, A. T., & Jennions, M. D. (2015). The extent and consequences of p-hacking in science. PLOS Biology, 13(3), e1002106. https://doi.org/10.1371/journal.pbio.1002106
- Lakens, D. (2015). On the challenges of drawing conclusions from p-values just below 0.05. PeerJ, 3, e1142. https://doi.org/10.7717/peerj.1142
p=0.049<0.050의 유혹에서 어떻게 벗어날 수 있는가?
연구자의 ‘재량’이 개입될 수 있는 가능성을 미리 제거하는 것이 중요합니다. 다음의 다섯 단계를 제안합니다.
- 데이터를 수집하기 전에 연구가설과 표본의 크기, 변수, 제외 기준, 분석 과정을 담은 한 장의 계획서를 설계합니다. 계획서를 OSF(Open Science Framework) 등에 공개하고 사전등록을 하는 것을 추천합니다.
- 검정력(power)의 크기를 사전에 셋팅하고 이를 기반으로 표본의 크기를 결정합니다. 분석 결과의 패턴을 관찰하면서 표본의 크기를 늘리려는 선택은 제1종 오류의 크기만을 키울 뿐입니다.
- 계산된 p값은 반올림을 하지 않고 소수점 셋째 자리까지 보고합니다. 그리고 효과의 크기와 신뢰구간을 함께 기재하고 p<0.05라는 기준만으로는 해석을 하지 않습니다.
- 측정한 변수와 통제 조건, 최종분석에서 제외한 모든 변수와 조건을 공개합니다.
- p<0.05의 판정 구간과 일치하는 p값이 관찰되었다면 별도의 민감도 분석(sensitivity analysis)을 수행하는 것이 바람직합니다. 이상치(outlier) 처리 방식을 변경한 후에 분석한 결과에서도 p=0.049가 유지되고 있다는 점을 방어합니다.
| 가상 사례: 경영학을 전공하는 박사과정 A씨는 조절효과를 분석한 후에 계산된 p값이 p=0.058인 것으로 나타났습니다. 2개의 이상치를 제거한 후에 동일한 분석을 수행한 결과에서는 p=0.047 값을 얻었습니다. 연구자는 이상치를 제거하지 않고 자신의 분석과정을 담은 계획서를 공개하기로 결정하였습니다. 사전에 등록한 분석 계획에 따라 p=0.058을 보고하고, 이상치 포함 vs. 이상치 제외한 두 결과를 민감도 분석결과와 함께 서술하였습니다. 그리고 효과의 크기와 신뢰구간의 값도 함께 기재하였습니다. A씨는 자신의 연구결과를 담은 논문의 원고(manuscript)를 SSCI급 해외저널에 투고하였습니다. 그리고 논문의 심사과정에서 심사위원 중의 한 명은 연구자가 보여준 통계분석 결과의 리포팅 방식을 높게 평가하였습니다. 이 사례는 프라임 컨설팅이 실무 현장에서 체험한 실제의 사례를 참고하여 재구성한 가상의 시나리오입니다. |
자주 묻는 질문 (FAQ)
Q. p=0.049<0.050 vs. p=0.051>0.050에 따라 서로 다른 연구결과로 해석해야 하나요?
A. 두 값의 차이는 사실상 없습니다. p<0.05는 Fisher가 어떠한 과학적인 근거도 가지지 않고 편의상 선택한 관례일 뿐입니다. 두 값을 구분하는 것은 오로지 논문 게재의 가능성에 관한 반응입니다.
Q. p-hacking이란 무엇인가요?
A. p값이 0.05 아래로 작아질 때까지 분석의 형태를 반복적으로 변경하는 행위입니다. 이상치 제거, 변수의 교체, 표본 추가 등이 대표적인 수단입니다. 고의가 아니더라도 연구자의 ‘재량’이 개입되면 동일한 결과를 얻을 수 있습니다.
Q. 통계분석의 결과를 확인한 뒤에 표본을 더 수집해도 되나요?
A. 사전에 미리 준비한 계획이 없이 분석결과의 추이를 관찰하면서 표본을 늘린다면 제1종 오류의 크기가 증가합니다. 만약 추가적으로 표본을 수집해야 한다면 그 사유와 보정절차를 계획서에 미리 밝혀야 합니다.
Q. 계산된 p값이 유의확률 0.05보다 조금 크다면 실패한 연구결과를 얻은 셈인가요?
A. 전혀 그렇지 않습니다. 효과의 크기와 신뢰구간을 함께 보고하면 p>0.05라도 연구결과가 중요한 시사점을 제공합니다. 특히, 실무적인 관점에서는 논문의 심사과정에서 더욱 긍정적이고 ‘정직하다’는 평가를 받을 수 있습니다.
Q. 논문의 심사위원은 p-hacking의 흔적을 어떻게 알 수 있나요?
A. 논문에 등장하는 p값들이 0.05 바로 아래에 몰려 있는지의 여부를 체크합니다. p-curve와 같은 진단 도구가 논문의 심사과정과 메타분석에서 이미 활용되고 있습니다.
Q. 사전등록이 학위논문을 준비할 때에도 반드시 필요한가요?
A. 의무는 아니지만 강력한 보호 장치가 됩니다. OSF 등록을 위해서 지불해야 하는 비용은 전혀 없습니다.
결론
p<0.05라는 기준은 Fisher가 편의상 정한 관례에 불과했습니다. 그런데 학술지들이 이 기준을 게재 여부를 판정하는 절대적인 조건으로 삼기 시작했습니다. p<0.05라면 논문이 학술지에 실리고, 그렇지 않다면 게재가 되지 않는 구조가 되어 버린 것입니다. 따라서 연구자들은 0.05를 조금 넘긴 p값을 0.05 아래로 낮추려고 p-hacking을 시도하게 되었습니다. 그 시도의 결과가 누적되기 시작하였고, 결국에는 학술지에 실린 p값들은 0.05 바로 아래 구간에 유난히 많이 몰리는 현상이 관찰되었던 것입니다.
p=0.049라는 값은 더 이상 그 자체로 결백을 보장받지 못합니다. 그리고 결백은 p값이 아니라 사전에 공개한 분석 절차로만 입증할 수 있습니다.