두 집단의 평균을 비교하기 위해서는, 두 집단이 설문 문항을 완벽하게 동일한 의미로 읽고 동일한 척도로 해석하였다는 '측정 동일성'이 통계적으로 먼저 입증이 되어야 합니다. 다집단 확인적 요인분석(MGCFA)을 수행한 검증 결과가 없이 무작정 도출된 평균의 차이는, 실제 개념 수준의 차이가 아닌 '문항 해석 편향'이 빚어낸 착시일 가능성이 매우 높습니다.
이 글의 순서 6개 항목
학위논문에서의 연구결과 챕터에 다음의 문장이 기술되어 있다고 가정해 보겠습니다.
“조직몰입 수준의 평균은 기성세대와 20대 그룹에서 각각 3.82점 및 3.54점으로 계산되었다. 그리고 독립표본 t-검정 을 수행한 결과, 세대 간의 차이가 통계적으로 유의한 것으로 나타났다(t=2.910, p<0.01). 따라서 20대 구성원의 조직몰입도는 기성세대에 비해 낮은 것으로 판단할 수 있다.”
보통의 연구자들은 이 문장에서 통계적인 유의성만을 확인한 후에 곧바로 결론 챕터를 작성하는 단계로 넘어갑니다. 그러나 다음 단계로 진입하기 전, 방법론적으로 치명적인 전제 조건이 완전히 누락되어 있습니다. 바로 ‘두 집단이 조직몰입 척도 문항들을 완벽하게 동일한 의미와 뉘앙스로 읽어내고 응답했는가’에 대한 통계적인 검증입니다.
만약 세대 간에 문항을 읽고 해석하는 인지적인 방식이 근본적으로 다르다면, 3.82 vs. 3.54의 차이는 실제 ‘조직몰입’ 수준의 차이를 입증하는 것이 아니라, 설문문항에 대한 ‘해석 양식의 차이’가 빚어낸 숫자의 착시 현상에 불과합니다. 이 전제 조건을 확인하는 통계적 절차를 ‘측정 동일성(measurement invariance)’ 검증이라고 부릅니다. 연구방법론 학자인 밴덴버그(Vandenberg)와 랜스(Lance)는 측정 동일성을 “집단을 비교하는 모든 연구가 반드시 거쳐야 할 논리적인 선행 조건”으로 주장하였습니다. 그리고 광범위한 연구에서 측정 동일성 검증이라는 필수적인 절차가 거의 대부분 생략되고 있음을 날카롭게 지적하였습니다.
평균 비교의 타당성을 붕괴시키는 두 가지 근본 원인
구체적인 설문문항 하나를 가정하여 응답이 왜곡되는 메커니즘을 살펴보겠습니다. 조직몰입의 수준을 측정하는 척도 중에서 “나는 회사의 성공을 위해 기대 이상의 노력을 기울일 의향이 있다”라는 문항이 있다고 가정하겠습니다.
기성세대의 응답자가 이 문항을 ‘조직에 대한 헌신과 충성심’을 묻는 질문으로 해석한다면, 조직몰입의 수준이 높다고 인식하는 사람일수록 당연히 높은 점수(예., 5점)에 응답할 것입니다. 이때 문항과 측정하고자 하는 ‘조직몰입’이라는 잠재개념은 매우 견고하게 연결되어 있습니다. 반면에, 20대 응답자가 동일한 문항을 ‘과도한 야근과 희생 강요’에 대한 질문으로 냉소적으로 해석한다면 어떻게 될까요? 이 경우, 실제 직무에 대한 몰입도가 높더라도 해당 문항에는 낮은 점수(예., 2점)로 응답하는 현상이 발생합니다. 즉, 집단에 따라 문항과 잠재개념 간의 연결 고리가 느슨해지거나 방향성이 달라지는 것입니다. 확인적 요인분석(confirmatory factor analysis)에서 이 연결의 강도를 나타내는 통계값이 바로 ‘표준화 요인 적재량(standardized factor loading)’입니다. 두 집단에서의 표준화된 요인 적재량 값이 통계적으로 다르다는 것은, 겉으로 보기에는 동일하다고 여겨지는 설문문항이 집단별에 따라 전혀 다른 무게감과 의미로 개념을 읽고 해석하며 측정하고 있음을 의미합니다.
설령, 표준화 요인 적재량의 값이 두 그룹 간에 서로 동일하더라도 치명적인 문제가 하나 더 남습니다. 바로 ‘절편(intercept)’의 차이입니다. 내면적으로 조직몰입의 수준이 완벽하게 동일한 두 사람을 가정하겠습니다. 한 사람은 평소에 점수를 후하게 주는 응답 습관을 가지고 있기 때문에 자신의 상태를 4점으로 표기하고, 다른 사람은 극단적인 점수를 피하는 문화적인 겸양이나 보수적 성향 때문에 동일한 내적 상태를 3점으로 표기할 수 있습니다. 이러한 응답 양식(response style)의 차이가 특정한 집단 전체의 편향된 경향성으로 나타난다면, 해당 문항은 집단별로 서로 다른 기본 점수, 절편 값을 갖게 됩니다.
절편 값이 다르면, 계산된 평균 점수의 차이에서 ‘실제 잠재개념의 차이’와 ‘응답 편향(습관)의 차이’가 통계적으로 완전히 혼재가 됩니다. 연구자는 이 둘을 분리할 수 있는 수학적인 방법론이 없으며, 따라서 두 평균의 값을 비교한 t-검정의 결과는 해석을 할 수 없는 상황에 놓여지게 됩니다.
Chen(2008)은 이와 같은 부적절한 비교가 얼마나 끔찍한 결과를 초래하는지를 시뮬레이션과 실증 연구를 통해 적나라하게 입증하였습니다. 측정 동일성이 확보되지 않은 상태에서 문화 간 또는 집단 간의 비교를 무리하게 수행할 경우, 집단 간에서 나타나는 차이의 크기가 왜곡되는 것을 넘어 아예 평균 차이의 방향성(+, -) 자체가 반대로 도출되는 현상까지 발생하였습니다. 이는 통계 프로그램이 출력한 유의확률(p<0.05)이 평균 비교에 대한 타당성을 결코 보장하지 못한다는 엄중한 경고이기도 합니다.
- Vandenberg, R. J., & Lance, C. E. (2000). A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research. Organizational Research Methods, 3(1), 4–70. https://doi.org/10.1177/109442810031002
- Chen, F. F. (2008). What happens if we compare chopsticks with forks? The impact of making inappropriate comparisons in cross-cultural research. Journal of Personality and Social Psychology, 95(5), 1005–1018. https://doi.org/10.1037/a0013193
다집단 확인적 요인분석을 활용한 측정 동일성의 4단계 검증 절차
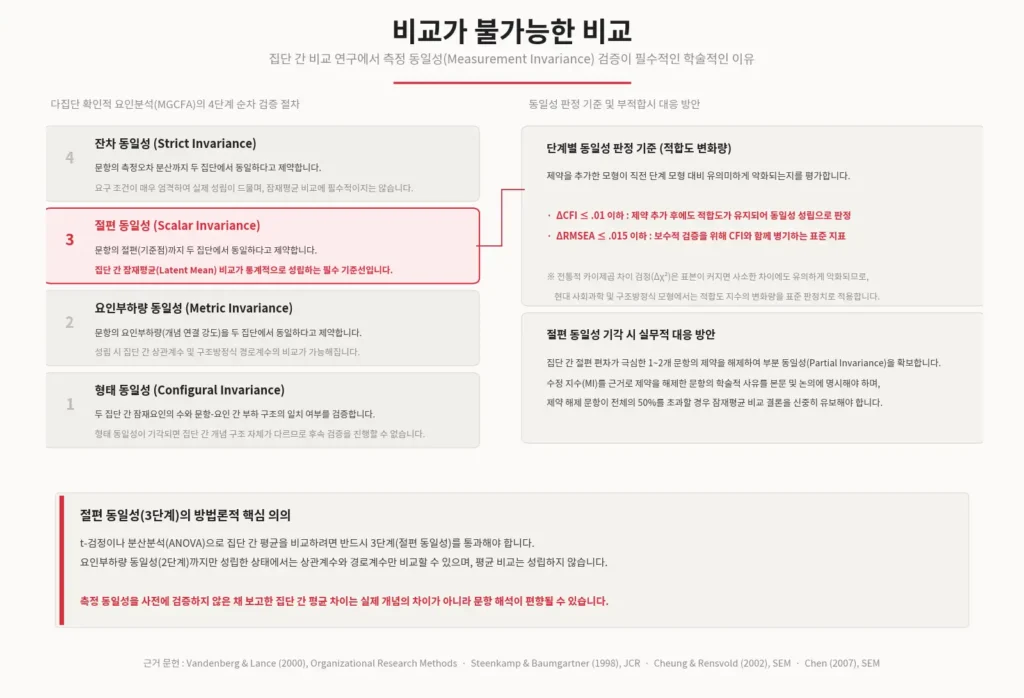
측정 동일성을 검증하는 핵심적인 통계 기법은 ‘다집단 확인적 요인분석(MGCFA: Multi-Group Confirmatory Factor Analysis)’입니다. 이 분석은 비교하고자 하는 집단들에 대해서 동일한 요인구조 모형을 동시 적용한 후, 모수에 대한 통계적인 제약을 하나씩 추가해 가며 모형의 전반적인 적합도(goodness-of-fit)가 유의하게 악화되는지를 단계별로 평가하는 방식입니다. 제약을 가했음에도 불구하고 적합도가 기존 모형과 유사하게 유지된다면, 두 집단에서는 측정 동일성이 성립한 것으로 판정합니다.
Steenkamp & Baumgartner(1998)가 설계한 4단계의 순차적 검증을 위한 표준 절차는 다음과 같습니다.
- 형태 동일성 (configural invariance): 집단 간의 제약을 전혀 가하지 않은 기저 모형(baseline model)입니다. 두 집단에서 잠재요인의 개수와 각 문항이 어느 요인에 속하는지(요인 구조의 패턴)가 시각적으로 동일한지를 검증합니다. 만약 이 첫 단계에서 적합도가 기각된다면, 두 집단은 애초에 완전히 다른 개념 체계를 구축하고 있기 때문에 연구를 그 시점에서 중단해야 합니다.
- 요인부하량 동일성 (metric invariance): 각 문항이 잠재요인을 설명하는 가중치인 ‘요인적재량’이 두 집단에서 동일하다고 제약합니다. 만약 이 단계가 성립한다면, 두 집단의 응답자들이 각 설문문항을 개념적으로 동일한 척도로 이해하고 있음이 입증됩니다. 이 조건이 충족되면 두 집단 간의 ‘상관관계’나 ‘회귀계수’의 크기를 비교할 수 있는 자격이 주어집니다.
- 절편 동일성 (scalar invariance / intercept invariance): 설문문항의 요인적 재량뿐만 아니라, 각 문항의 고유한 기준점인 ‘절편’까지 두 집단에서 동일하다고 제약합니다. 이 단계가 바로 잠재평균(latent mean) 비교를 수행하기 위한 마지노선입니다. 앞서 기술한 예시에서와 같이, 기성세대(=3.82)와 20대(=3.54)의 평균 값을 서로 비교하기 위해서는 반드시 이 3단계 제약 모형의 적합도를 통과해야만 합니다.
- 잔차 동일성 (strict invariance / residual invariance): 각 설문문항이 가진 고유한 측정 오차 분산(residual variance)마저 두 집단에서 동일하다고 제약하는 가장 가혹한 단계입니다. 이 조건은 현실적으로는 성립하는 경우가 극히 드물며, 현대 통계학계에서는 잠재평균을 비교하는 데 잔차 동일성까지는 요구되지 않는다는 견해가 지배적입니다.
단계에 따라 측정 동일성의 성립 여부를 판정하는 기준은 크게 두 가지입니다. 첫째는 전통적으로 널리 사용되는 ‘카이제곱 차이 검정(2 test)’입니다. 제약을 가한 모형과 제약 이전 모형 간의 카이제곱 값 차이를 계산하여 유의성을 판정합니다. 그러나 카이제곱 통계량은 표본 크기에 극도로 민감하기 때문에, 표본의 크기가 큰 대규모 연구에서는 부적합한 지표로 평가받습니다.
두 번째 대안은 적합도 지수의 절대적인 변화량(change in fit indices)을 확인하는 것입니다. Cheung & Rensvold(2002)는 시뮬레이션 연구를 수행한 결과를 기반으로 비교 제약 모형 간의 ΔCFI가 가장 신뢰할 만한 지표라고 주장하였습니다. 그리고 제약 추가 전후의 ΔCFI의 악화 폭이 0.01 이하이면 측정 동일성이 성립한 것으로 판정할 수 있다고 논의하였습니다. 이후에 Chen(2007)은 집단 간의 표본 불균형 문제를 보완하는 세부 기준을 추가로 제안하였는데, 오늘날의 논문심사 과정에서는 CFI과 함께 RMSEA 기준을 교차로 함께 보고하는 방식이 학계의 표준으로 자리 잡았습니다.
- Steenkamp, J.-B. E. M., & Baumgartner, H. (1998). Assessing measurement invariance in cross-national consumer research. Journal of Consumer Research, 25(1), 78–90. https://doi.org/10.1086/209528
- Cheung, G. W., & Rensvold, R. B. (2002). Evaluating goodness-of-fit indexes for testing measurement invariance. Structural Equation Modeling, 9(2), 233–255. https://doi.org/10.1207/S15328007SEM0902_5
- Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
절편 동일성이 기각되었을 때의 대안: 부분 동일성(Partial Invariance)
하지만, 현실적으로는 설문 데이터을 분석하는 과정에서 3단계인 절편 동일성을 검증할 때 ΔCFI가 임계치(0.01)를 초과하여 동일성이 붕괴되는 현상이 비일비재하게 발생합니다. 그렇다면 평균의 비교를 포기하고 연구를 전면 폐기해야 할까요? 그렇지는 않습니다.
Byrne et al.(1989)이 제안한 ‘부분 동일성(partial invariance)’ 접근법은 완벽한 대안으로 평가받고 있습니다. 모든 설문문항의 절편을 동시에 완벽히 동일하다고 강제로 제약하는 대신, 적합도 악화의 주범이 되는 1-2개의 ‘문제 문항’을 색출하여 해당 문항들에 한해서만 집단 간의 절편 제약을 해제해 주는 방식입니다. 통계 프로그램(AMOS, Mplus 등)이 제공하는 ‘수정 지수(Modification Index, MI)’를 계산하는 알고리즘이 바로 부분 동일성을 기반으로 설계된 것입니다. 집단 간의 차이가 비정상적으로 큰 문항의 제약을 순차적으로 풀어주면, 나머지 대다수의 문항들을 통해 부분적인 동일성이 확보되어 제한적이나마 집단 간의 잠재평균 비교 절차를 이어갈 수 있습니다.
단, 제약을 해제할 때는 절대 기계적으로 접근해서는 안 되며, 어떤 문항의 제약을 해제했는지를 그 설문문항의 내용적인 특성과 이론적 당위성을 논문에서 상세하게 기술해야 합니다. 또한, 특정한 잠재요인을 구성하는 문항 중에서 제약이 풀린(즉, 동일성이 깨진) 문항의 비율이 50%를 초과한다면, 잔존한 문항만으로는 해당 개념의 평균 비교를 정당화하기 어렵게 됩니다. 따라서 평균의 차이에 대해서 단정적으로 해석하지 말아야 합니다.
가장 최근에는 Robitzsch & Lüdtke(2023)를 중심으로 완벽한 측정 동일성의 검증이 집단 비교를 위한 절대적인 전제조건이 아니라는 의견이 등장하고 있습니다. 그리고 정렬법(alignment) 등의 대안적인 접근이 필요하다는 방법론적인 반론도 제기되고 있습니다. 사실, 이점들은 연구방법론을 다루는 학자들 간에 이루어지는 매우 첨예한 논쟁거리이기도 합니다. 그러나 학위논문 심사나 KCI/SSCI 학술지 투고를 준비하는 연구자의 입장에서는 상황을 단순명료하게 판단해야 합니다. 논문심사 위원의 대다수는 여전히 Vandenberg & Lance(2000)가 제시한 ‘선행 조건론’을 절대적인 기준으로 삼으며 논문을 평가하기 때문입니다. MGCFA를 수행하고 CFI 값을 기술한 테이블을 충실하게 리포팅한 연구자는 심사위원의 어떠한 비판에도 물러설 수 없는 방어선을 구축할 수 있습니다.
- Byrne, B. M., Shavelson, R. J., & Muthén, B. (1989). Testing for the equivalence of factor covariance and mean structures: The issue of partial measurement invariance. Psychological Bulletin, 105(3), 456–466. https://doi.org/10.1037/0033-2909.105.3.456
- Robitzsch, A., & Lüdtke, O. (2023). Why full, partial, or approximate measurement invariance are not a prerequisite for meaningful and valid group comparisons. Structural Equation Modeling, 30(6), 859–870. https://doi.org/10.1080/10705511.2023.2191292
측정 동일성의 검증 결과 리포팅을 위한 5단계 지침
Putnick & Bornstein(2016)은 심리학 및 사회과학 문헌에서 관찰되고 있는 측정 동일성에 관한 보고 실태를 전수 조사하고 체계적인 가이드라인을 발표하였습니다. 이 가이드라인과 최신 학술지 심사 트렌드를 종합한 ‘논문 작성 5단계 원칙’은 다음과 같습니다.
- 연구방법론 챕터에 검증 절차를 명시: 독립표본 t-검정이나 분산분석(ANOVA), 또는 다집단 구조방정식 등을 사용하여 두 개 이상의 집단을 비교하는 모든 연구가설의 검증 단계 이전에, “사전 전제조건으로서 다집단 확인적 요인분석(MGCFA)을 수행하여 측정 동일성을 검증하였다”라는 선언적인 문장을 연구방법론 챕터에 반드시 기술해야 합니다. 이는 성별과 세대, 국가, 소속 기업을 비교하는 횡단적 연구(cross-sectional study)뿐만 아니라, 동일한 응답자의 패널 데이터를 시계열로 비교하는 종단 연구(longitudinal study)에도 동일하게 의무 적용됩니다.
- 집단별 표본의 크기 및 균형을 확인: 다집단 CFA 모형이 안정적으로 수렴하기 위해서는 각각의 비교 집단이 최소 200명 내외의 유효 표본을 확보하는 것이 바람직합니다. 특히 집단 간의 표본 크기가 극단적으로 비대칭이라면(예., A=500명, B=50명), 적합도 지수의 변화량(ΔCFI) 추정치가 심각하게 왜곡되기 때문에 분석을 수행하기 전에 표본의 크기가 균형을 이루고 있는지의 여부를 체크해야 합니다.
- 4단계 통합 테이블을 작성: 형태 동일성, 요인부하량 동일성, 절편 동일성, (잔차 동일성)을 포함하는 각 제약 단계별로 계산된 적합도(2, CFI, RMSEA)와 전 단계와 비교한 상대적인 변화량(CFI, ΔRMSEA)을 테이블로 통합하여 기술합니다.
- 부분 동일성(Partial Invariance) 해제 사유에 관한 정성적인 서술: 절편 동일성이 기각되어 수정 지수(MI)를 기반으로 특정한 설문문항의 제약을 해제했다면, 논문의 본문에서는 “제약이 해제된 문항은 [문항 내용]이며, 이는 집단 간의 문화적인 배경 차이로 인하여 해석의 편차가 발생한 것으로 예상할 수 있다”라는 구체적인 정성적 근거를 서술해야 합니다. 이 서술 방식은 논문에서의 논의(discussion) 챕터를 풍부하게 만드는 소장한 학술적인 자산이 됩니다.
- 측정 동일성의 검증 결과가 기각이 되었을 때 한계점을 명시적으로 선언: 만약 여러 설문문항의 제약을 해제했음에도 절편의 부분 동일성조차 확보하지 못한 상태에서 부득이하게 평균의 비교를 강행해야 한다면, 연구의 한계점을 기술하는 챕터에 그 사실을 투명하게 서술해야 합니다. 예를 들어서, “본 연구가 수행한 집단 간의 평균 차이를 검증한 결과에서는 잠재개념의 실제적인 차이 외에도 측정 도구 자체의 편향이 일정 부분 혼재되어 있을 가능성을 배제할 수 없다”라고 선제적으로 방어하는 태도는 논문심사 위원의 공격을 회피하는 방패가 됩니다.
| 가상 사례: 간호학 박사과정생의 측정 동일성 심사 방어 과정 간호학 박사과정에 재학 중인 연구자 A씨는 종합병원 간호사(집단 1)와 요양병원 간호사(집단 2) 간의 직무 소진과 직무 스트레스 수준의 평균 차이를 평가하기 위하여 독립표본 t-검정을 수행하였습니다. 그리고 이 연구결과를 기반으로 원고를 작성하여 KCI 등재 학술지에 투고했습니다. t-검정을 수행한 결과, 두 집단의 평균값 간에 관찰된 차이는 통계적으로 유의한 것으로 나타났습니다. A씨는 이를 근거로 “요양병원 간호사들의 직무 소진이 더 심각하다”라는 단정적인 결론을 투고한 원고세어 서술하였습니다. 그러나 1차 논문심사의 과정에서 통계 방법론에 엄격한 한 명의 심사위원이 제동을 걸었습니다. “근무 환경의 특수성이 현격히 다른 두 병원 집단이 직무 소진 설문 문항들을 완벽히 동일한 의미로 인식했는지 검증되지 않았다. 따라서, 측정 동일성을 검증한 결과를 추가해서 보완해야 한다”라는 심사위원의 평가의견과 함께 ‘수정 후 재심(major revision)’으로 판정하였습니다. 연구자는 AMOS 프로그램을 사용하여 다집단 확인적 요인분석(MGCFA)을 수행하였습니다. 1단계 형태 동일성과 2단계 요인부하량 동일성(ΔCFI = .003)은 무난히 통과했으나, 평균 비교의 관문인 3단계 절편 동일성 단계에서 하지만 A씨는 수정 지수(MI)를 정밀하게 분석하였습니다. 그 결과 “야간 교대 근무로 인한 체력적인 한계”를 묻는 단 하나의 문항에서 두 집단 간 절편 수치의 극단적인 편차가 발생하였다는 사실을 확인할 수 있었습니다(종합병원은 3교대가 필수인 반면, 요양병원은 야간 전담 체제로 운영이 되기 때문에 근무 패턴의 기준 자체가 달랐기 때문입니다). A씨는 문제를 일으켰던 문항의 절편 제약만을 해제하는 ‘부분 동일성’ 모형을 적용하였고, 검증을 다시 수행한 결과 ΔCFI=0.005이라는 안정적인 적합도를 확보할 수 있었습니다. 논문의 수정본에서는 4단계를 거친 측정동일성의 검증 결과를 통합한 새로운 테이블을 수록하였습니다. 그리고 제약조건을 해제한 문제 문항의 내용과 그 원인(예., 교대 근무 체계의 차이)을 논리적으로 서술하였습니다. 나아가서는, 논의 챕터에서는 해당 문항이 두 병원 집단에서 상이하게 해석될 수밖에 없었던 간호 현장의 구조적인 차이를 선명하게 해석하였습니다. (본 사례는 보건학 분야에서의 학술지 논문 컨설팅 사례를 기반으로 재구성한 가상의 시나리오입니다.) |
자주 묻는 질문 (FAQ)
Q. 측정 동일성 검증은 통계 분석의 어느 단계에서, 정확히 어떤 연구 설계에 적용해야 합니까?
A. 상관분석이나 단일 집단을 대상으로 수행하는 회귀분석에서는 요구되지 않습니다. 오직 ‘복수의 집단을 상호 비교하는 모든 연구 설계’에 적용됩니다. 예를 들어서, 성별(남성 vs. 여성)과 세대(MZ세대 vs. X세대 vs. 베이비부머 세대), 소속(대기업 vs. 공기업), 국적(한국 vs. 미국) 등의 독립된 횡단적 두 집단의 t-검정, 분산분석, 다중집단 구조방정식 모형 분석을 수행하기 전에 반드시 수행해야 합니다. 또한, 동일한 표본 응답자를 시간차를 두고 여러 번 측정한 후에 나타나는 변화를 비교하는 종단 연구를 설계할 때에도 시점 간 측정 동일성(longitudinal measurement invariance) 검증이 필수적으로 수반되어야 합니다.
Q. 평균을 비교하기 위해서는 4단계 검증 중 어느 단계까지 통과해야 합니까?
A. 3단계인 절편 동일성까지 통과해야 두 집단의 잠재평균의 차이를 통계학적으로 정당하게 비교할 수 있습니다. 2단계인 요인부하량 동일성까지만 통과했다면, 설문문항의 척도 단위만 동일해진 상태이므로 변수 간의 ‘상관관계’나 ‘구조 모형의 경로계수’를 비교하는 수준까지만 허용될 뿐 평균의 비교는 여전히 금지됩니다.
Q. 적합도 지수 기반의 판정 기준은 현재 학계에서 어떻게 통용되고 있습니까?
A. 과거에는 통계적 가설 검정인 카이제곱 차이 검정이 주로 쓰였으나, 표본이 클수록 미세한 오차에도 동일성이 기각되는 과잉 민감성으로 인하여 오늘날의 사회과학 영역에서는 점차 배제되고 있습니다. 현재 가장 널리 통용되는 절대적인 표준은 Cheung & Rensvold(2002)가 제안한 CFI 값을 기준으로 하며, 보수성을 높이기 위해 RMSEA 변화량을 함께 리포팅하는 방식이 A급 국제 학술지(SSCI) 내에서 암묵적인 규칙으로 자리 잡았습니다.
Q. 절편 동일성 검증에 거듭 실패하여 결국 요인부하량 동일성 수준에 머물렀다면 논문의 평균 비교 분석을 포기해야 합니까?
A. 포기하지 마십시오. 이때 동원하는 무기가 바로 Byrne(1989)가 제안한 ‘부분 동일성’ 검증입니다. 적합도를 훼손하는 집단 간의 편차가 극심한 1-2개의 문항을 찾아내고 그 문항에 한해서만 제약을 해제하면, 다른 문항들의 도움(?)을 얻게 되어 부분적으로 측정동일성을 통과할 수 있는 조건을 확보하게 됩니다. 단, 제약을 해제한 설문문항이 전체 척도 문항의 50%를 초과할 경우에는 더 이상 동일한 개념을 측정하고 있다고 보기 어렵기 때문에 가능한한 해석의 톤을 낮추고 연구 한계점에 명시해야 합니다.
Q. 비교할 두 집단의 표본 크기는 각각 어느 정도를 확보해야 다집단 요인분석이 타당하다고 판단할 수 있나요?
A. 공분산 구조를 안정적으로 추정하기 위해서는 일반적으로 각각의 비교 집단이 200명 안팎의 유효 표본을 확보하는 것이 권장되고 있습니다. 그러나 현실적으로 분석을 수행하는 과정에서는 표본의 크기만큼이나 중요한 것은 두 집단 간에 관찰되는 표본 크기의 균형입니다. 남성 400명 vs. 여성 50명과 같이 극단적으로 불균형 상태에서 다집단 분석을 수행한다면면 소수 집단의 분산이 다수 집단에 압도되어 ΔCFI 통계량이 심각하게 왜곡됩니다. 따라서 사전에 무작위 추출을 통해 표본의 크기를 조정해야 합니다.
Q. 만약 측정 동일성 검증을 굳이 언급하지 않고 기존의 관행대로 SPSS에서 곧바로 독립표본 t-검정만 수행하여 테이블을 제시하면 어떻게 됩니까?
A. 국내에서 출판되는 KCI 등재지에서는 측정 동일성을 검증한 후에 집단 간의 평균의 차이 검증을 수행한 연구의 사례는 오직 소수의 연구에서만 관찰되고 있습니다. 만약 연구방법론적인 전문성을 갖춘 논문심사 위원이 심사를 한다면 “비교를 위한 전제가 전혀 검증되지 않았다”라는 의견과 함께 ‘게재 불가’ 판정을 내릴 가능성이 높습니다. 이를 예방할 수 있는 유일한 방법은 측정 동일성을 충실하게 검증하고 그 결과를 논문의 원고에 기술하는 것 이외에는 방법이 전혀 없습니다.
결론
우리나라 대학교의 통계학 수업에 입문하는 대학원생들이 가장 먼저 배우고, 가장 빈번하게 논문에 적용하는 통계 기법은 집단의 평균을 비교하는 t-검정과 분산분석입니다. 몇 번의 클릭만으로도 SPSS가 결과 테이블을 출력해주고, 이 테이블에 등장하는 값으로 초보 연구자들은 별다른 의심 없이 통계적 유의성(p-value)을 논문에서의 결론으로 기술합니다.
그러나 이처럼 평화로워 보이는 평균 계산 공식의 이면에는 “두 비교 집단의 응답자들이 설문 문항들을 완벽하게 동일한 인지적인 뉘앙스와 동일한 척도 단위로 해석했다”라는 거대하고 무거운 이론적인 가정이 숨겨져 있습니다. 이 숨겨진 가정이 붕괴되는 순간, 논문에서 정리한 평균값의 유의한 차이는 진실이 아니라, ‘집단 간 인지적인 편향의 차이’가 빚어낸 허구의 숫자로 전락하게 됩니다.
이 치명적인 파국을 사전에 막기 위해 반드시 수행해야 하는 통계적 검증, 즉 다중집단 확인적 요인분석(MGCFA)을 수행하기 위해 필요한 시간은 고작 반나절에 그치는 수고에 불과합니다. 한편, 이 검증을 애써 무시한다면, 무척 까다로운 논문심사 위원으로부터 ‘게재 불가’ 또는 ‘수정 후 재심사’라는 판정을 받게 될 가능성이 매우 큽니다. 만약, 성별, 세대, 직급, 국가 등의 집단 간을 비교하는 연구가설을 다루는 논문을 준비중이라면 다중집단 확인적 요인분석을 통해 반드시 측정 동일성을 검증하기 바랍니다.