통제변수를 많이 투입할수록 분석이 엄격해진다는 잘못된 믿음은 방법론을 다루는 문헌에서 '도시전설'로 분류되었습니다. 매개변수를 통제하면 관심변수의 영향력 일부가 제거되고, 충돌변수를 통제하면 존재하지도 않았던 인과관계가 만들어지게 됩니다. 통제변수는 개수가 아니라 인과관계적인 역할의 분류로 결정해야 합니다. 통제변수를 선정하는 방법을 알려드립니다.
이 글의 순서 6개 항목
대학원에서 대대로 전해지는 조언이 하나 있습니다. 가능하다면 통제변수(control variable)를 몇 개 더 넣으라는 것입니다. 변수를 많이 통제할수록 분석이 엄격해 보이고, 논문 심사위원의 지적도 줄어든다는 이유이기 때문입니다. 실제로 이미 출판된 다수의 논문들에서 관찰되는 모습도 이 조언에서와 유사합니다. Spector & Brannick(2011)의 조사에 따르면, 조직 수준(organizationial level)에서 다루는 논문 한 편에는 평균 7.7개, 그리고 개인 수준(individual level)에서 수행한 연구결과를 담은 논문 한 편에는 평균 3.7개의 통제변수를 투입하는 것으로 나타났습니다. 그런데 연구방법론에 관한 다수의 문헌이 주장하는 결론은 이 조언과는 정반대입니다. 아무런 근거 없이 투입한 통제변수는 분석을 엄격하게 만드는 것이 아니라, 오히려 관심변수(또는 독립변수)의 계수 값을 예측할 수 없는 방향으로 오염시킨다는 것입니다. 이 글은 통제변수를 어떠한 기준으로 선택해야 하는지를 소개합니다.
- Spector, P. E., & Brannick, M. T. (2011). Methodological urban legends: The misuse of statistical control variables. Organizational Research Methods, 14(2), 287–305. https://doi.org/10.1177/1094428110369842
더 많은 통제변수를 투입할 수록 좋다는 잘못된 믿음은 어디서 등장하였는가?
그 믿음의 기원은 정화 원리(purification principle)라고 불리우는 암묵적인(implicit) 가정으로부터 비롯된 것 같습니다. 관심변수와 결과변수(또는 종속변수)의 관계에는 다른 변수들의 영향이 혼재되기 때문에, 그 변수들을 통제하면 순수한 인과관계를 선명하게 관찰할 수 있다는 가정입니다. 만약 이 가정이 사실이라면 통제변수를 많이 투입할 수록 바람직합니다. 하지만 Spector & Brannick(2011)은 이 가정을 정면으로 반박하였습니다. 통제변수를 아무런 근거도 없이 투입하는 관행은 근거가 검증되지 않은 채 전승되는 ‘방법론적인 도시전설(methodological urban legend)’에 불과하다는 것입니다.
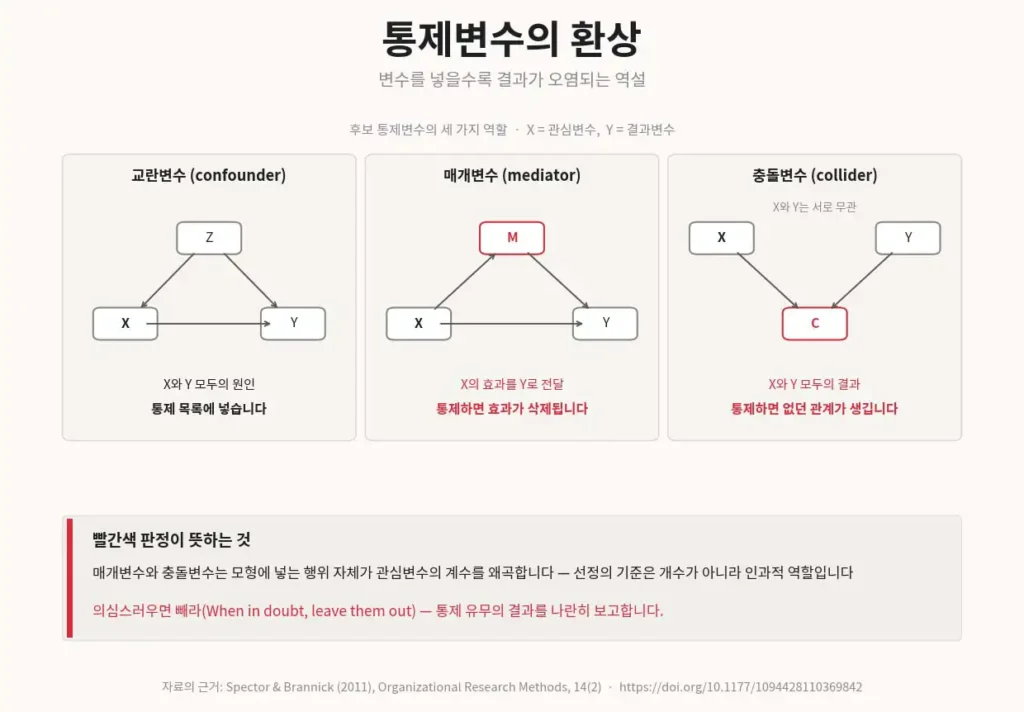
구체적으로, Spector & Brannick(2011)가 주장하는 점은 다음과 같습니다. 통계 프로그램은 연구자의 의도를 알지 못합니다. 프로그램이 하는 일은 고작 통제변수의 영향과 중복되는 다른 변수의 영향을 계산에서 제거하는 것 뿐입니다. 그런데 이렇게 제거된 결과 값이 정화 과정에서 나타난 것인지, 또는 왜곡에 의한 것인지는 그 통제변수가 실제로 어떤 역할을 했는지에 따라서 결정됩니다. 만약 통제변수가 교란변수(confounder)이면 정화가 되고, 매개변수라면 영향력이 제거되며, 충돌변수라면 애초에 존재하지도 않았던 인과관계가 창조됩니다. 그래서 연구자가 해야 할 일은 두 가지입니다. 하나는 만약 통제변수로 투입된 변수를 통제하지 않았다면 그 변수가 했었을 역할을 논문에서 밝히는 것입니다. 예를 들어서, “조사 대상자의 연령은 운동 시간과 주관적 건강 점수 모두에게 영향을 미치는 교란변수로 판단하였기 때문에 통제변수로 투입하였다”라고 서술합니다. 다른 하나는 통제변수의 역할에 따라 타당한 분석을 수행하는 것입니다. 통제변수가 교란변수라면 통제를 하는 것이 타당한 분석입니다. 또는 통제변수가 매개변수의 역할을 한다면 통제를 해서는 안되고 오히려 매개모형으로 설계를 수정해야 합니다.
Carlson & Wu(2012)는 Spector & Brannick(2011)이 지적한 통제변수 투입의 옳지 않은 관행에 대해서 ‘통계적 통제의 환상(illusion of statistical control)’이라고 언급하고 서로 유사한 주장을 제시하였습니다. 그리고 통제변수와 관심변수 사이에 상관관계가 존재한다면 통제는 관심변수의 계수 값을 크게 하거나 또는 작게 만들수 있으며 부호도 바꿀 수 있다고 주장하였습니다.
- Carlson, K. D., & Wu, J. (2012). The illusion of statistical control: Control variable practice in management research. Organizational Research Methods, 15(3), 413–435. https://doi.org/10.1177/1094428111428817
통제변수 하나가 어떻게 결과를 오염시키는가?
오염을 시키는 대표적인 메커니즘은 크게 두 가지입니다.
첫 번째 메커니즘은 애초부터 매개변수의 역할을 가지는 매개변수를 통제하는 것입니다. 예를 들어서, 교육훈련의 지각된 품질이 직무성과에 미치는 영향을 추정하는 연구를 수행한다고 가정하겠습니다. 교육훈련으로부터 높은 수준의 품질을 인식한다면 높은 수준의 자기효능감으로 이어질 가능성이 크고, 결국 높은 수준의 직무성과로 이어질 가능성이 큽니다. 이 연구모형에서 자기효능감은 교육훈련의 영향이 직무성과로 이어지게 하는 매개변수입니다. 그런데 만약 연구자가 자기효능감을 통제변수로 회귀모형에 투입한다고 가정하겠습니다. 회귀분석은 자기효능감의 수준이 서로 유사한 자료들끼리 비교하는 방식으로 교육훈련의 영향력 계수를 계산합니다. 교육훈련의 영향력 중에서 자기효능감을 거쳐 영향력이 전달되는 부분이 계산에서 통째로 빠지는 것입니다. 교육훈련의 효과가 대부분 자기효능감을 통해 전달된다면, 교육훈련의 영향력 계수는 0에 가까워지고 연구자는 “교육효과가 직무성과에 미치는 영향은 유의하지 않은 것으로 나타났다”라는 잘못된 결론에 이르게 됩니다. 이것이 바로 ‘과잉통제 편향(overcontrol bias)’입니다. 만약 독립변수의 영향력을 매개하는 매개변수를 통제한다면, 말 그대로 통제라는 이름으로 독립변수의 영향력을 삭제하게 됩니다.
두 번째 메커니즘은 충돌변수(collider)의 통제입니다. 충돌변수는 관심변수와 결과변수 양측의 영향을 받는 변수입니다. 재능과 노력이 서로 아무 관계가 없음을 특징으로 하는 집단을 다룬다고 가정하겠습니다. 그리고 이 집단이 어떤 시험에 응시한 후에, 재능과 노력의 합산점수가 기준을 넘기는 사람만을 합격한다고 가정하겠습니다. 따라서 합격의 여부는 재능과 노력으로부터 동시에 영향을 받기 때문에 충돌변수입니다. 이제 합격자들만을 놓고 재능과 노력의 관계를 계산해 봅니다. 재능이 높은 합격자는 노력이 부족해도 합산점수가 기준을 넘게되어 합격할 수 있습니다. 반면에, 재능이 낮은 합격자는 노력이 상당히 커야만 합격할 수 있습니다. 따라서 합격자 집단 내에서는 재능이 높을수록 노력이 낮은 관계, 곧 음(-)의 상관으로 계산됩니다. 이 마이너스 상관은 전체 집단에서는 존재하지 않았던 관계입니다. 합격의 여부를 통제변수로 모형에 투입하는 것은 합격자끼리, 또는 불합격자끼리 비교하는 것이기 때문에 왜곡이 발생합니다. Cinelli(2024)는 매개변수와 충돌변수의 통제를 ‘나쁜 통제(bad control)’로 분류하였습니다.
종합한다면, 이들 두 메커니즘이 가지는 공통점은 통제변수를 투입한 행위 자체가 결과를 오염시킨다는 것입니다.
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552
논문들에서 관찰되는 통제변수의 투입 관행은 실제로 어떤 모습인가?
Becker(2025)는 조직의 수준에서 수행한 연구 논문들에서 나타나는 통제변수의 투입에 대해 질적연구를 수행하였습니다. 그리고 연구의 결과에서는 통제변수를 왜 투입하였는지의 이유를 밝히지 않는 논문이 대부분을 차지하는 것으로 나타났습니다. Bernerth & Aguinis(2016)의 연구결과도 Becker(2025)의 주장을 뒷받침하고 있습니다. 조사 대상자의 성별과 나이를 포함하는 인구통계적 프로파일 변수를 어떠한 이론적인 근거도 제시하지 않고 단지 관행으로 투입하는 사례가 가장 흔하게 관찰되는 것으로 나타났습니다(Bernerth & Aguinis, 2016). 반면에, 투입된 통제변수가 관심변수 및 결과변수와는 어떠한 인과 관계를 가지는지를 탐색한 연구의 사례는 극소수인 것으로 조사되었습니다. 각 연구논문마다 투입한 통제변수의 종류가 서로 다르다면, 유사한 주제를 다루는 연구결과들 내에서 계수 값을 서로 비교할 수 없으며, 나아가서는 메타분석을 수행할 수 없게 만듭니다.
Becker(2005)의 “의심스러우면 빼라(When in doubt, leave them out)”라는 주장은 통제변수의 투입에 관해 가장 널리 인용되는 문장입니다. 통제변수를 투입하는 결정에는 이론적인 근거가 필요하지만, 투입하지 않는 결정에는 근거가 없어도 문제가 발생하지 않는다는 의미입니다. 그리고 투입해야 하는 근거를 제시하지 못하는 변수라면 투입하지 않는 것이 왜곡의 위험을 최소화한다는 뜻입니다.
- Becker, T. E. (2005). Potential problems in the statistical control of variables in organizational research: A qualitative analysis with recommendations. Organizational Research Methods, 8(3), 274–289. https://doi.org/10.1177/1094428105278021
- Bernerth, J. B., & Aguinis, H. (2016). A critical review and best-practice recommendations for control variable usage. Personnel Psychology, 69(1), 229–283. https://doi.org/10.1111/peps.12103
- Becker, T. E., Atinc, G., Breaugh, J. A., Carlson, K. D., Edwards, J. R., & Spector, P. E. (2016). Statistical control in correlational studies: 10 essential recommendations for organizational researchers. Journal of Organizational Behavior, 37(2), 157–167. https://doi.org/10.1002/job.2053
통제변수의 선정을 위한 절차는 무엇인가?
지금까지 이루어진 논의의 중심은 통제 자체를 해서는 안된다는 의미가 전혀 아닙니다. 관심변수와 결과변수 모두에게 영향을 미치는 교란변수의 통제는 인과관계의 추정을 위해서는 반드시 요구됩니다. 만약 교란변수를 통제하지 않는다면 관심변수의 계수 값에 다른 변수의 효과와 서로 혼재되기 때문입니다. 다만, 관련 문헌이 주장하는 것은 통제변수의 역할을 따지지 않는 통제, 곧 근거가 전혀 없는 통제라는 점에 있습니다. 반드시 통제해야 할 변수는 교란변수이고, 통제를 해서는 안되는 변수는 매개변수와 충돌변수이며, 이에 대한 판단 기준은 통제변수의 개수가 아니라 연구변수 간의 인과관계적인 역할입니다. 통제변수의 선정을 위한 다섯 단계는 다음과 같습니다.
- 첫째, 통제변수의 후보마다 인과관계적인 역할을 식별합니다. 관심변수와 결과변수에 영향을 미치는 원인을 제공한다면 교란변수, 관심변수의 결과임과 동시에 결과변수의 원인이라면 매개변수, 두 변수 모두의 결과이면 충돌변수, 그리고 어느 변수와도 인과 관계가 없다면 연구가 관심을 가질 필요가 전혀 없는 무관한 변수입니다.
- 교란변수로 식별된 변수만을 통제변수로 투입합니다. 매개변수와 충돌변수, 그리고 연구와는 무관한 변수는 통제변수 리스트에서 삭제합니다.
- 조사 대상자의 성별과 나이, 근속연수, 연 평균 소득수준 등을 포함하는 인구통계적 변수도 위의 단계를 통해 통제변수의 유무를 판단해야 합니다. 다른 유사한 논문에서 통제변수로 투입되었다는 사실은 전혀 문헌적인 근거로서 활용될 수 없습니다.
- 통제변수가 투입된 회귀모형 vs. 투입되지 않은 회귀모형의 검증 결과를 서로 비교합니다. 만약 비교분석의 결과에 차이가 관찰된다면, 이는 통제변수의 영향에 대한 유익한 정보로 활용될 수 있고, 독자와 심사위원의 판단 근거로 작용합니다.
- 통제변수를 투입한 후에 관찰되는 결과의 해석은 오직 관심변수의 계수 값으로 제한해야 합니다. 반드시 통제변수의 계수 값과 부호를 해석하면 안됩니다.
| 가상 사례: 심리학 석사과정에 재학 중인 한 연구자는 직장인 교육훈련이 직무성과에 미치는 영향을 분석하였습니다. 분석의 엄격함을 드러내기 위해서 자기효능감을 포함하는 6개의 통제변수를 회귀모형에 투입한 후에 나타난 결과를 살펴보았습니다. 하지만 연구자의 예상과는 다르게, 교육훈련의 영향력 계수 값은 유의하지 않은 것으로 나타났습니다. 이후에, 연구자는 자기효능감이 훈련의 효과를 성과로 전달하는 매개변수의 역할을 한다는 점을 뒤늦게 확인할 수 있었습니다. 이에 따라 연구자는 통제변수의 목록에서 자기효능감을 제거하고 분석을 다시 수행하였는데, 이번에는 교육훈련의 계수 값이 통계적으로 유의한 것으로 나타났습니다. 연구자는 매개모형으로 연구모형을 다시 설계하였습니다. 그리고 교육훈련에 의한 총효과(total effect)와 자기효능감을 거쳐 직무성과에 이르는 간접효과(indirect effect)를 구분하여 연구결과를 리포팅하였습니다. 이 사례는 프라임 컨설팅이 실무 현장에서 체험한 상황을 참고하여 재구성한 가상의 시나리오입니다. |
자주 묻는 질문 (FAQ)
Q. 통제변수를 분석모형에 많이 투입할 수록 분석이 엄격해지나요?
A. 전혀 그렇지 않습니다. 이 잘못된 믿음은 관련 문헌에서 ‘통계적 통제의 환상’으로 불리울 만큼 전혀 근거가 없는 것으로 확인되었습니다. 아무런 근거가 없이 변수를 통제한다면 관심변수의 계수를 왜곡할 뿐입니다.
Q. 투입해야 하는 통제변수 vs. 투입해서는 안되는 변수를 어떻게 구분하나요?
A. 인과관계적인 역할의 유무 여부로 구분합니다. 만약 어떤 변수가 관심변수와 결과변수 모두에게 원인이라면 그 변수는 교란변수이며, 교란변수는 반드시 통제해야 합니다. 관심변수의 영향력을 전달하는 매개변수와, 두 변수 모두의 결과인 충돌변수는 통제가 되어서는 안됩니다.
Q. 매개변수를 통제하면 어떤 일이 발생하나요?
A. 관심변수가 미치는 영향 중에 매개변수를 거쳐 전달되는 영향력이 계산에서 제거됩니다. 영향력이 실제로 존재함에도 불구하고 계수 값이 0에 근접해지기 때문에 효과가 없다는 잘못된 결론에 이를 수 있습니다.
Q. 충돌변수를 통제하면 어떤 일이 발생하나요?
A. 실제로는 무관한 두 변수 사이에 존재하지도 않는 상관관계가 만들어집니다. 충돌변수의 값이 유사한 수준끼리 비교하는 과정에서 두 변수가 서로 반대 방향으로 묶이는 왜곡이 발생하기 때문입니다.
Q. 성별과 나이 등을 포함하는 인구통계적 변수를 통제하는 것은 관행으로 여겨지고 있습니다.
A. 관행이 근거가 될 수는 없습니다. 오직 성별과 나이가 관심변수와 결과변수 모두의 원인이 될 때에만 통제의 근거를 갖추게 됩니다. 이와 관련한 문헌들은 근거를 제시하지 않고 인구통계적 변수를 통제하는 것이 가장 흔하게 관찰되는 문제라고 지적하였습니다.
Q. 통제변수를 타당하게 선정하였지의 여부를 심사위원에게 어떻게 설명하나요?
A. 각 통제변수의 투입 근거를 연구방법론에 서술합니다. 그리고 통제변수가 투입된 모형 vs. 투입되지 않은 모형의 분석 결과를 서로 비교하여 별도의 비교 테이블을 리포팅합니다.
결론
뚜렷한 역할이 없는 변수를 통제한다면 관심변수의 효과를 제거하고, 존재하지 않았던 인과관계를 새로 만들기도 하며, 유사한 영역을 다루는 연구들끼리의 비교를 불가능하게 만듭니다. 통제의 가치는 투입하는 통제변수의 갯수로 판단하지 않습니다. 투입한 변수가 교란변수라고 주장할 수 있는 문헌적인 근거를 제시할 때에만 그 가치가 드러나게 됩니다.